¿Qué es SAP Document AI? El vocabulario de la serie
Ciclo de vida de un documento, schemas, plantillas, métodos de extracción, score de confianza y lo que hay que montar en SAP BAIP para usar SAP Document AI.
Por Grecia Rodríguez 9 min de lectura
Muchos procesos de negocio siguen empezando con un documento: un pedido de compra en PDF, una factura escaneada, un aviso de pago. Alguien lo lee y teclea los datos en SAP. SAP Document AI (antes SAP Document Information Extraction, nombre que todavía aparece en muchas pantallas, roles y APIs) automatiza ese paso: recibe el documento y devuelve sus datos como campos estructurados, listos para que otro programa cree con ellos un pedido de venta, una factura de proveedor o lo que corresponda.
Lo importante es que Document AI no crea nada en SAP. Solo extrae. Siempre hay una capa de integración, por ejemplo ABAP, CAP o Integration Suite, que lee esos campos y llama a la API de SAP que toque. Buena parte de los problemas de esta serie están justo en esa frontera.
El ciclo de vida de un documento en SAP Document AI
Todo documento que entra en Document AI pasa por las mismas cinco etapas:
- Subida. Se envía el archivo junto con su tipo de documento (pedido de compra, factura…) y el schema o la plantilla con los que hay que leerlo.
- Extracción. El servicio procesa el documento de forma asíncrona y devuelve dos grupos de campos: los de cabecera, que aparecen una vez por documento (número de pedido, fecha, proveedor), y los de posición, que se repiten en cada línea (material, cantidad, precio). Cada campo trae su valor y un score de confianza.
- Revisión. Una persona abre el resultado en la interfaz de Document AI, lo compara con el documento original y corrige los campos que estén mal.
- Confirmación. El documento se marca como definitivo.
- Consumo. La capa de integración lee el resultado por API y crea el objeto en SAP.
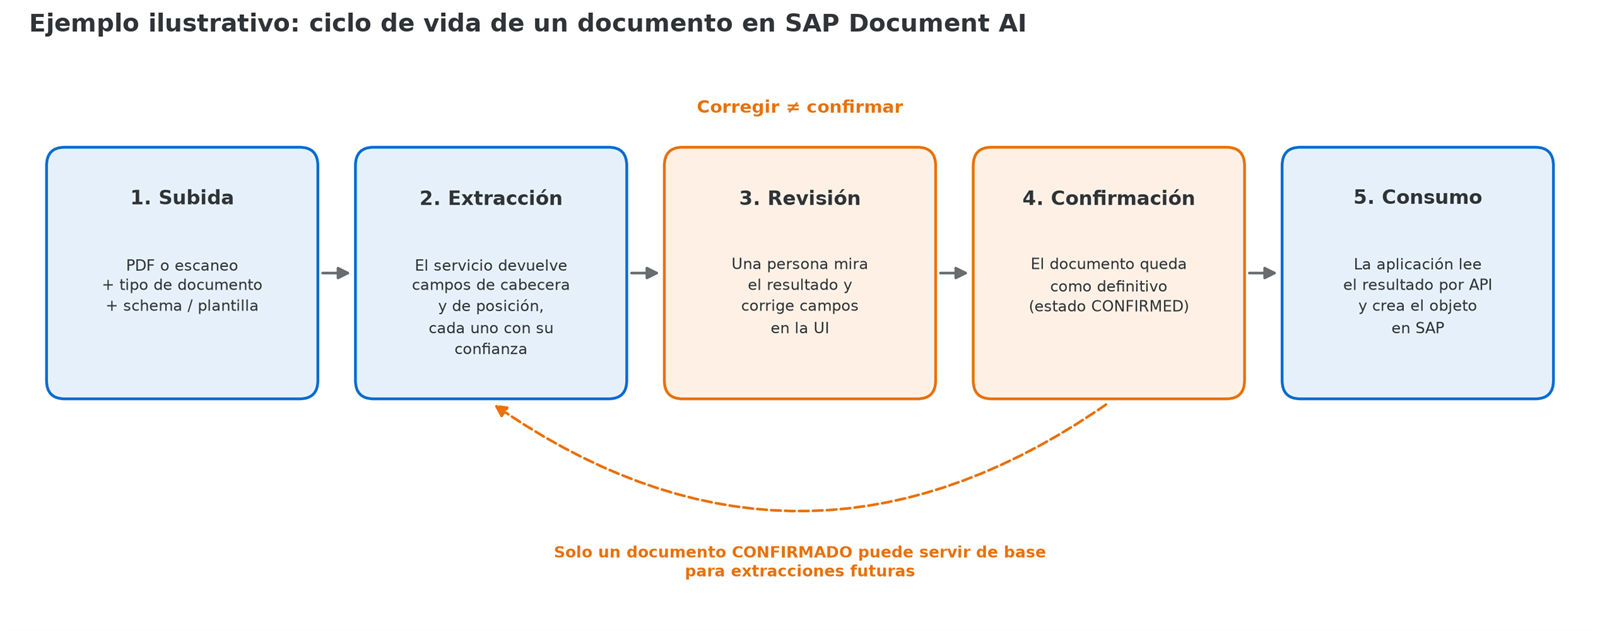
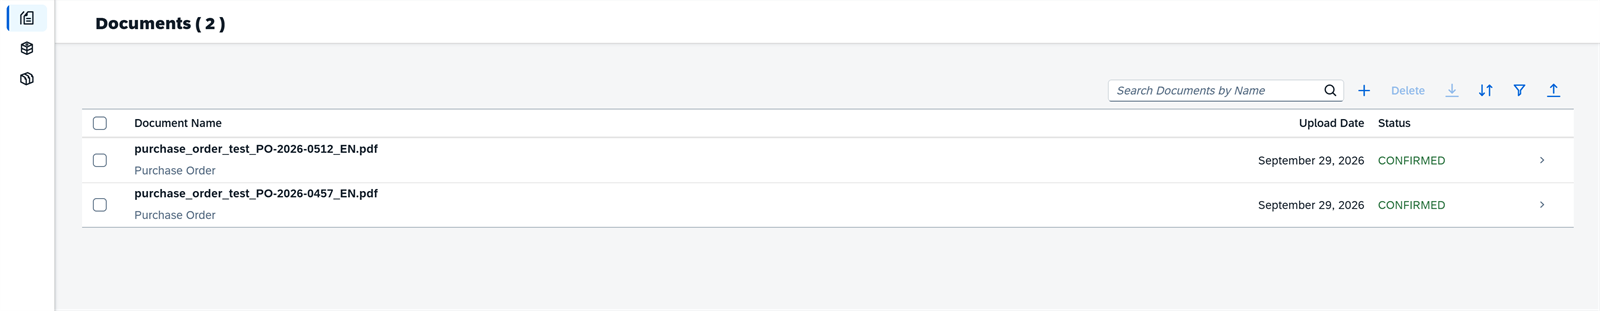
Conviene retener un detalle desde ya: corregir y confirmar son dos acciones distintas, aunque se hagan en la misma pantalla. Corregir deja bien ese documento concreto. Confirmar lo convierte en definitivo, y solo los documentos confirmados sirven de referencia para mejorar las extracciones siguientes (más abajo se explican las dos formas en que el servicio los aprovecha). En la práctica es fácil corregir sin confirmar y quedarse esperando a que el modelo «aprenda».
En muchos procesos, las etapas 3 y 4 no son obligatorias para todos los documentos: si la extracción es buena, la integración puede consumir el resultado directamente. Decidir qué documentos necesitan revisión humana y cuáles no es una de las decisiones de diseño más delicadas, y ahí es donde entra el score de confianza.
Las piezas del modelo
Schema
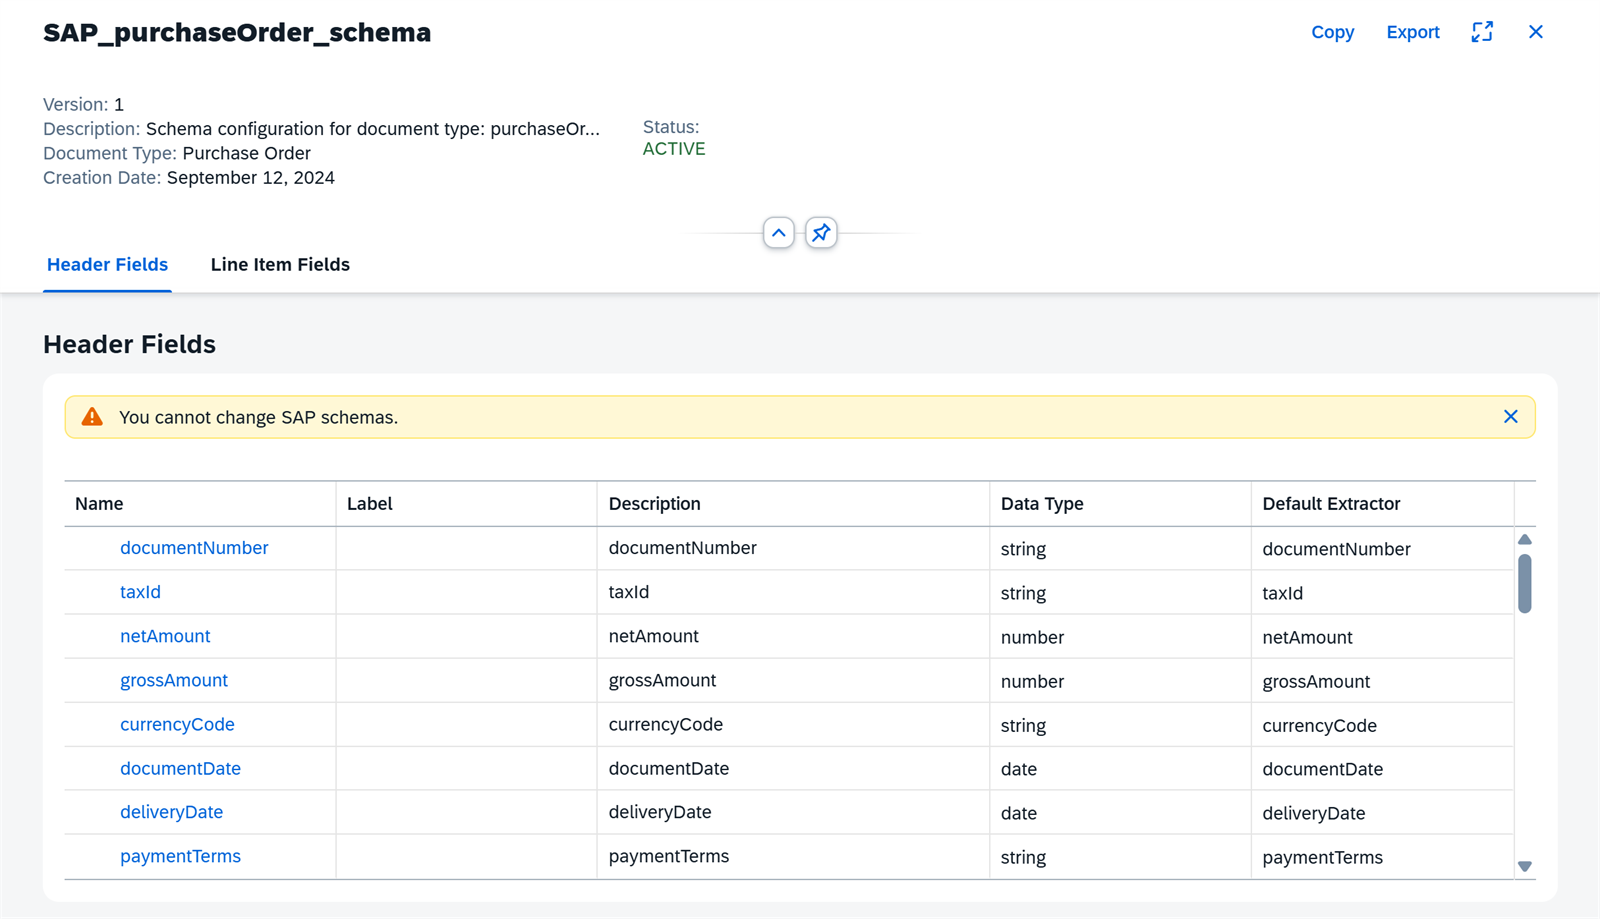
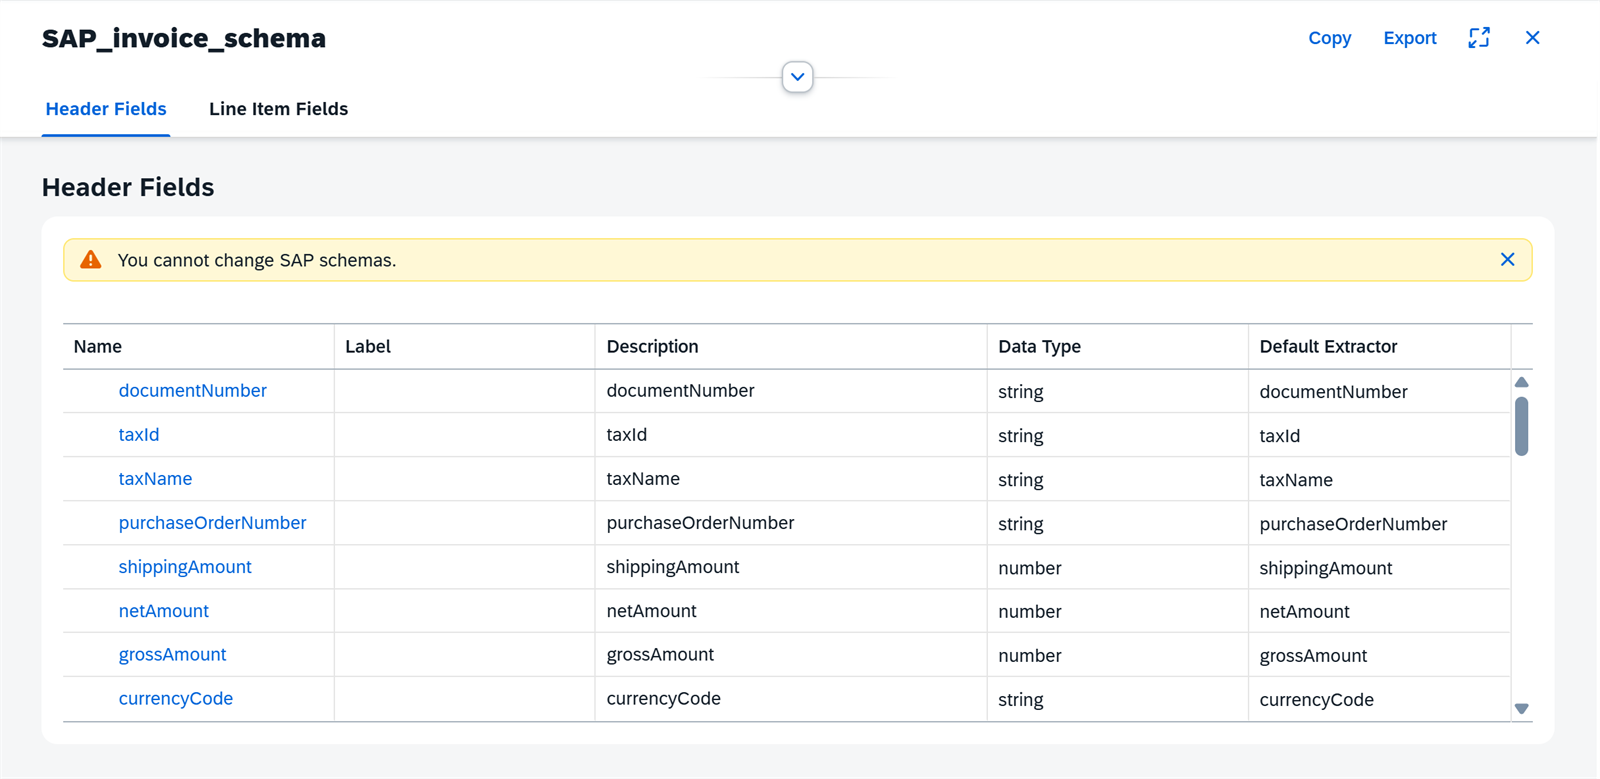
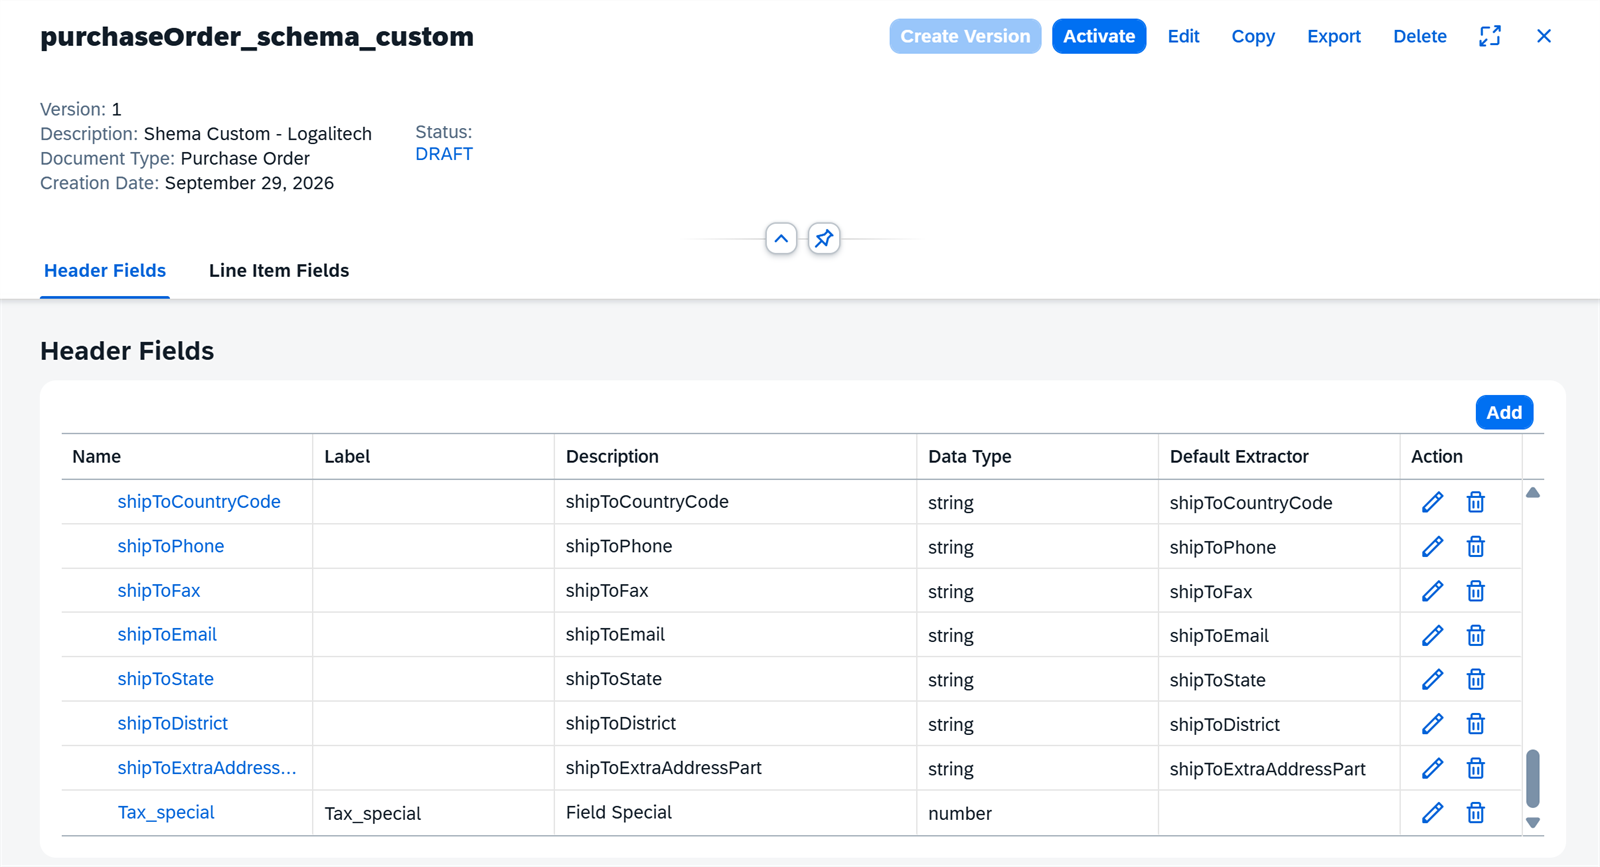
El schema define qué hay que extraer: la lista de campos de cabecera y de posición, y el tipo de dato de cada uno (texto, número, fecha…). SAP entrega schemas estándar para los tipos de documento habituales, como SAP_purchaseOrder_schema para pedidos de compra o SAP_invoice_schema para facturas. Para tener uno propio, se puede crear desde cero o copiar el estándar y modificar la copia.
Campos estándar y personalizados
Un schema puede tener dos clases de campos:
- Estándar: los define SAP, con un nombre fijo (por ejemplo
supplierMaterialNumberocustomerMaterialNumberen pedidos de compra), y los modelos del servicio ya saben encontrarlos. - Personalizados: los define el proyecto para datos que el estándar no cubre, como un código interno o un campo propio de un cliente concreto.
En la interfaz y en el JSON de respuesta parecen iguales, pero no se extraen igual. Los campos personalizados se resuelven según el método de extracción configurado en la plantilla (ver más abajo), y eso influye en cómo se comporta su confianza. Conviene tratarlos como dos familias distintas.
Importante: los campos personalizados solo existen en schemas personalizados. Un schema estándar de SAP (como
SAP_purchaseOrder_schema) contiene únicamente campos estándar y no se puede modificar. Si necesitas un campo propio, primero tienes que crear tu propio schema, desde cero o copiando el estándar.
Plantillas
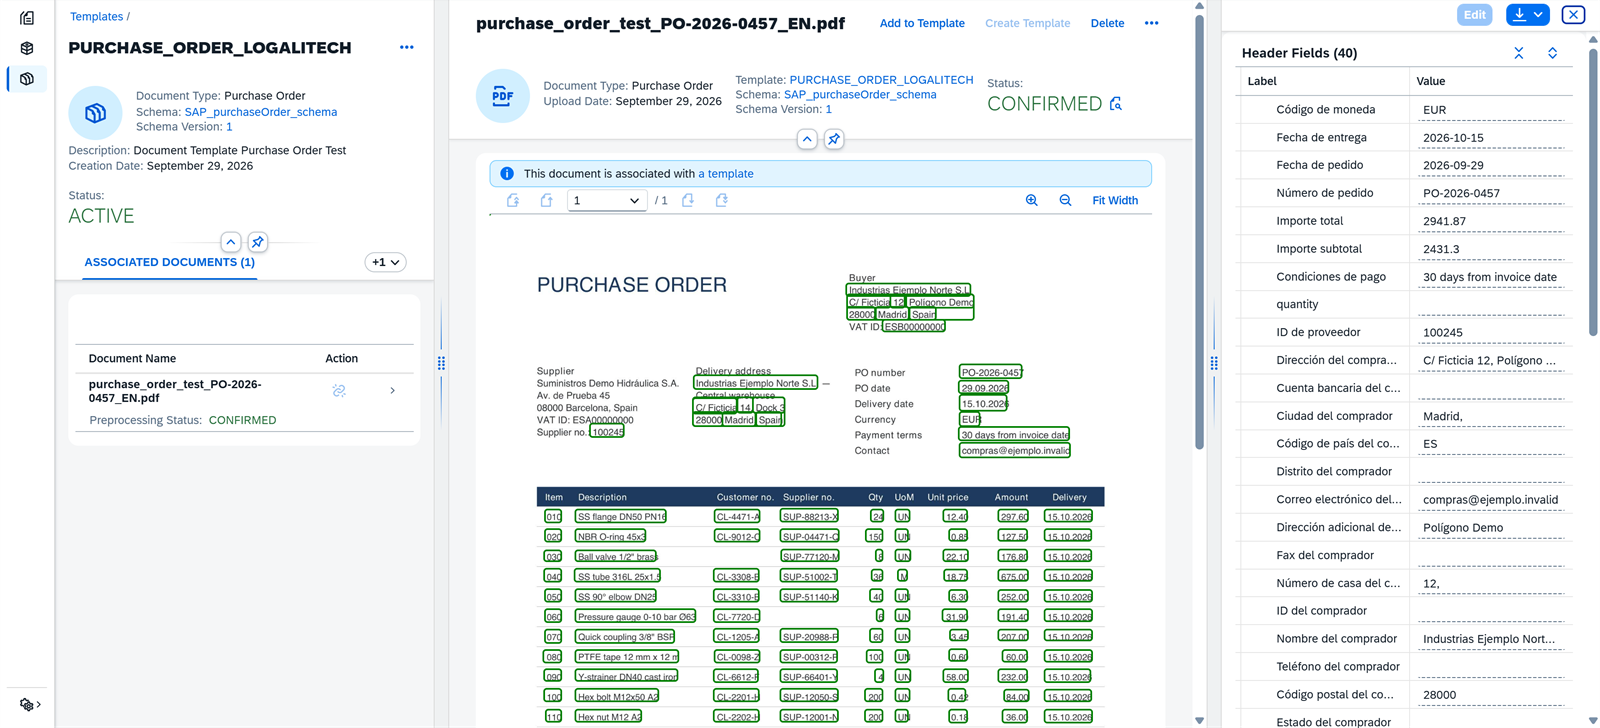
Una plantilla asocia un schema a un formato concreto de documento, normalmente el de un proveedor. Se construye con documentos de muestra de ese formato ya extraídos y confirmados, y le dice al servicio: «los pedidos de este proveedor tienen este aspecto, y los campos están aquí». Si hay dos proveedores con formatos distintos, lo normal es tener una plantilla para cada formato.
La calidad de una plantilla depende mucho más de la variedad de sus muestras que de su cantidad. Diez pedidos idénticos enseñan lo mismo que uno solo.
Métodos de extracción
Cada campo se extrae según el método de extracción que tenga asignado en la plantilla. Se configura campo a campo en la pestaña Extraction Fields, o para todos a la vez con Set Extraction Method for All, y hay tres opciones:
- Template Only: el servicio usa solo lo que aprendió de los documentos de muestra de la plantilla.
- AI Only: un modelo de lenguaje (LLM) lee el documento y busca el campo a partir de su nombre y de su descripción en el schema, sin apoyarse en las muestras.
- Template with AI: combina las dos. Es la opción que aparece por defecto.
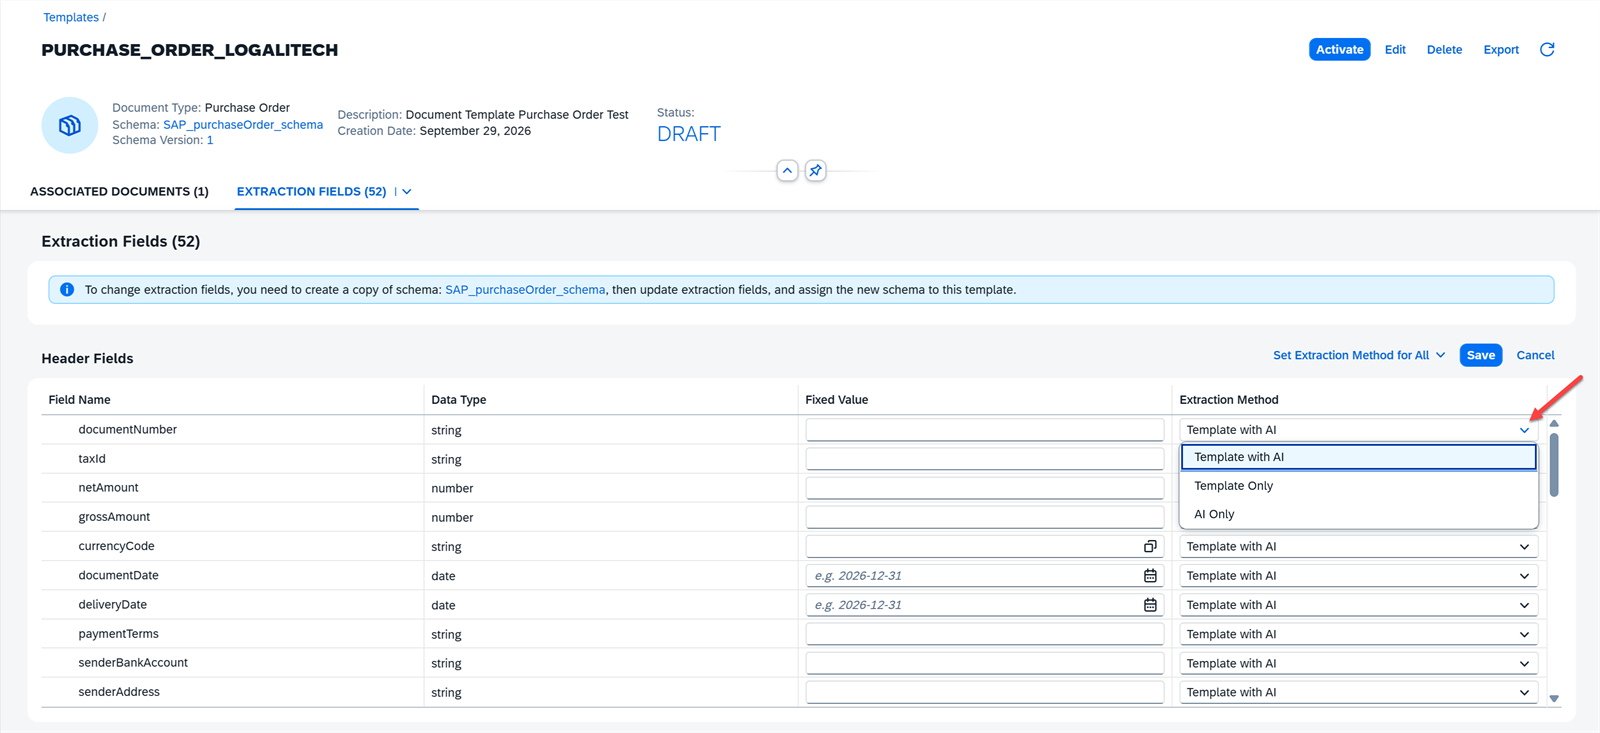
La misma pantalla recuerda la regla del apartado anterior: para cambiar los campos de extracción hay que copiar el schema estándar, modificar la copia y asignársela a la plantilla.
Instant learning
Además de las plantillas, el servicio puede usar los documentos que un usuario edita y confirma como referencia inmediata para los siguientes documentos parecidos, sin crear ni reentrenar una plantilla a mano. SAP llama a esto instant learning. Tiene una consecuencia directa: confirmar un documento mal corregido enseña el error con la misma eficacia que un acierto.
El score de confianza
Cada campo extraído viene con un valor de confianza entre 0 y 1 (la interfaz lo muestra como porcentaje). Se suele leer como «qué tan seguro está el servicio de que este valor es correcto». La interfaz de revisión lo pinta por colores para que la persona sepa dónde mirar primero: rojo por debajo del 51 %, naranja entre el 51 % y el 80 %, y verde a partir del 80 %.
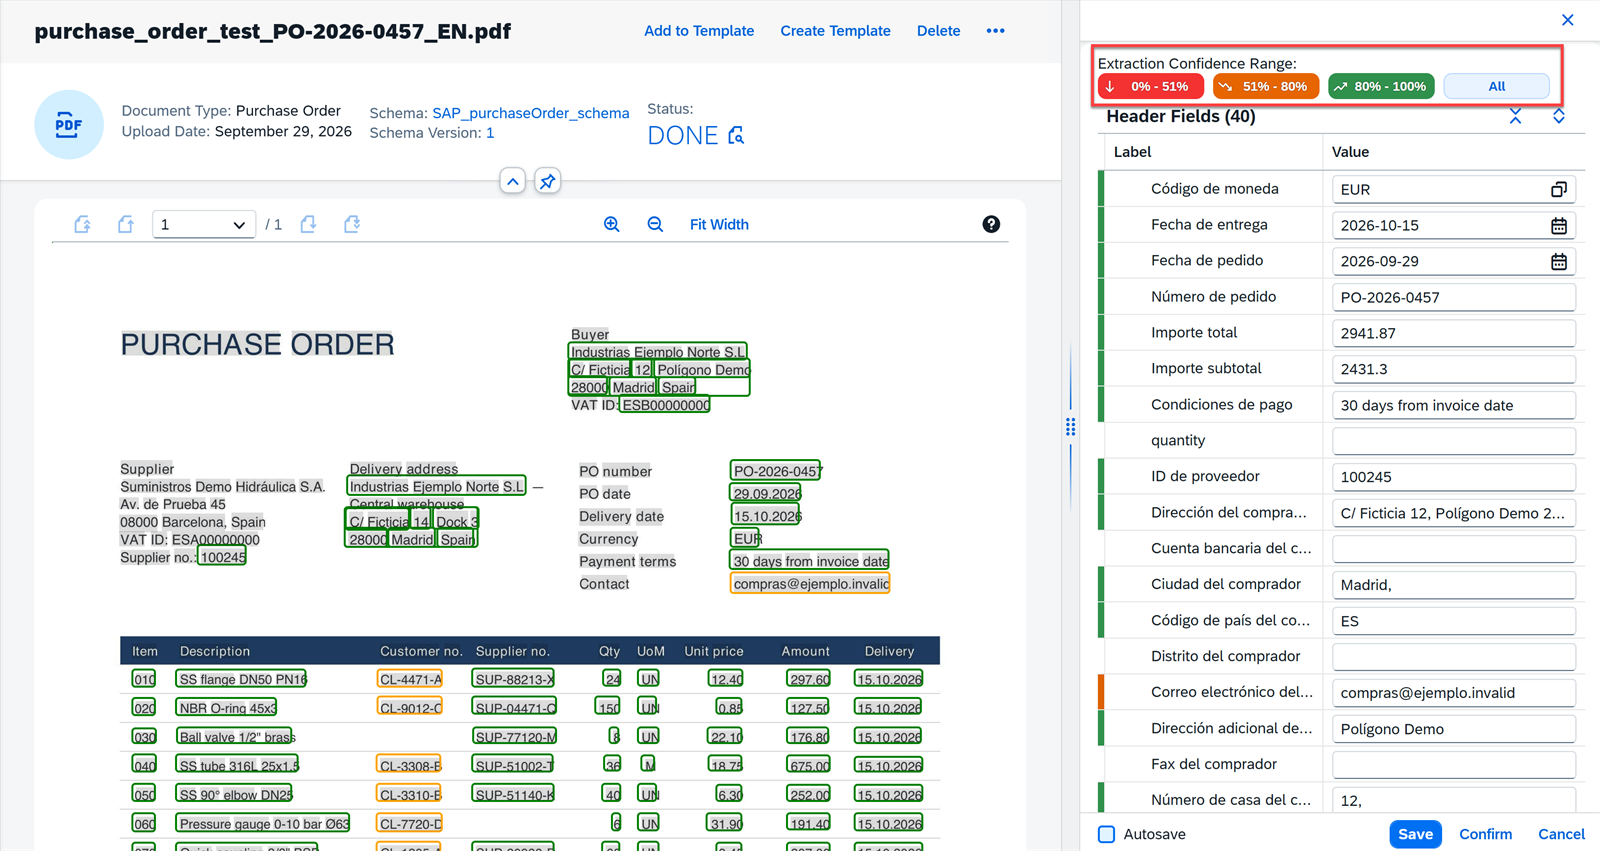
La tentación es inmediata: fijar un umbral, por ejemplo 0,8, dejar que todo lo que esté por encima pase directamente a SAP y mandar a revisión lo que quede por debajo. Es un diseño razonable y muy común. Pero para que funcione, ese número tiene que comportarse como una señal fiable en cada uno de los campos sobre los que se decide.
Qué hay que montar en SAP BAIP
Document AI es un servicio de SAP BAIP. Para usarlo hacen falta dos accesos: el de la integración, que llama a la API, y el de las personas, que configuran schemas y plantillas y revisan documentos. La diferencia entre suscribirse a una aplicación y crear una instancia de servicio se explica en Subscriptions vs service instances en SAP BAIP.
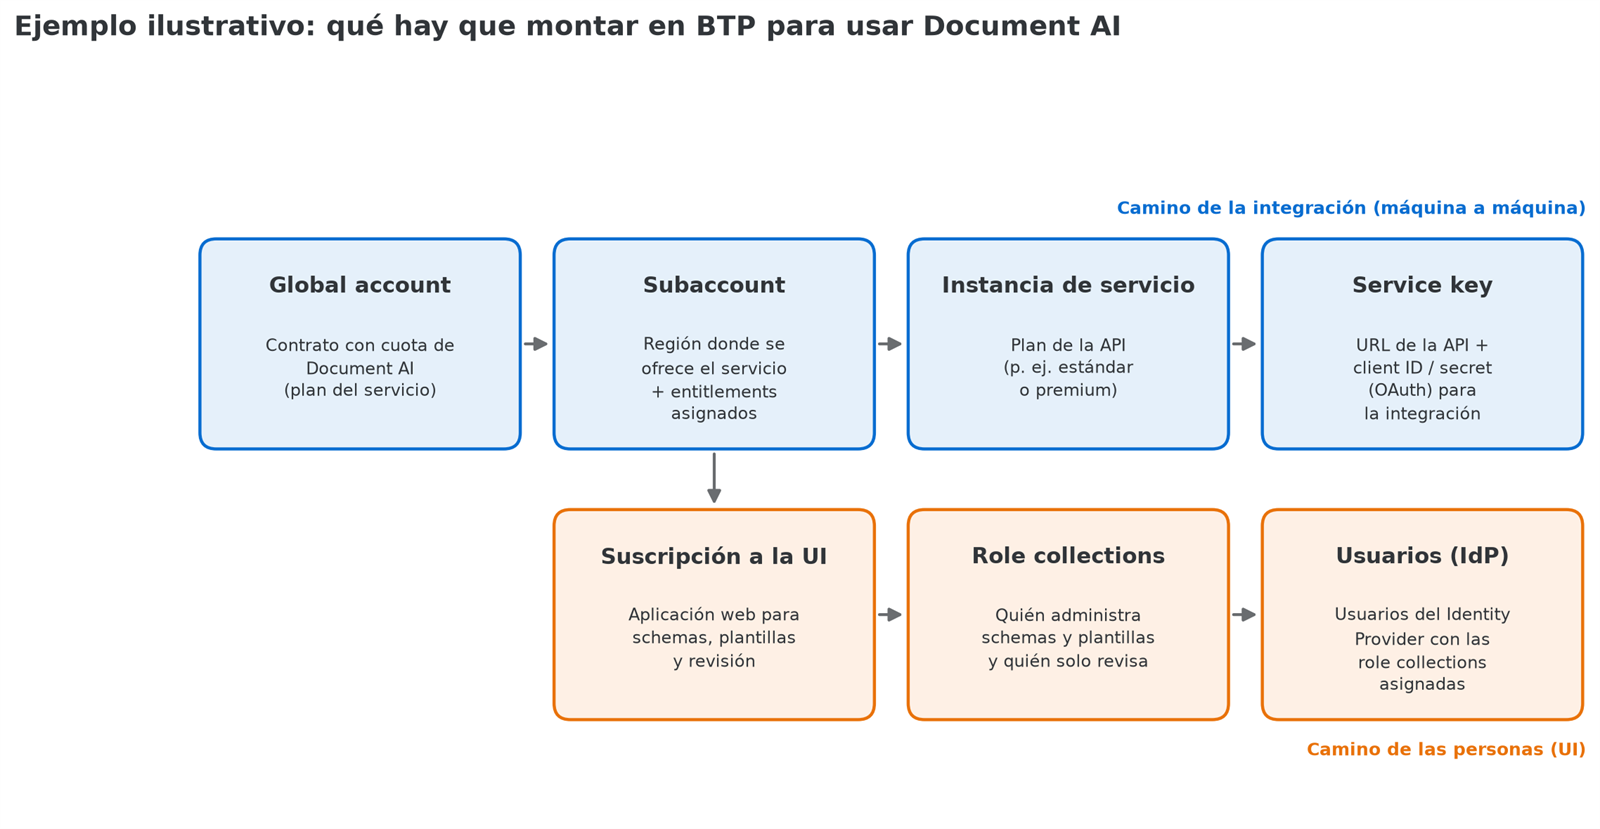
Para la integración:
-
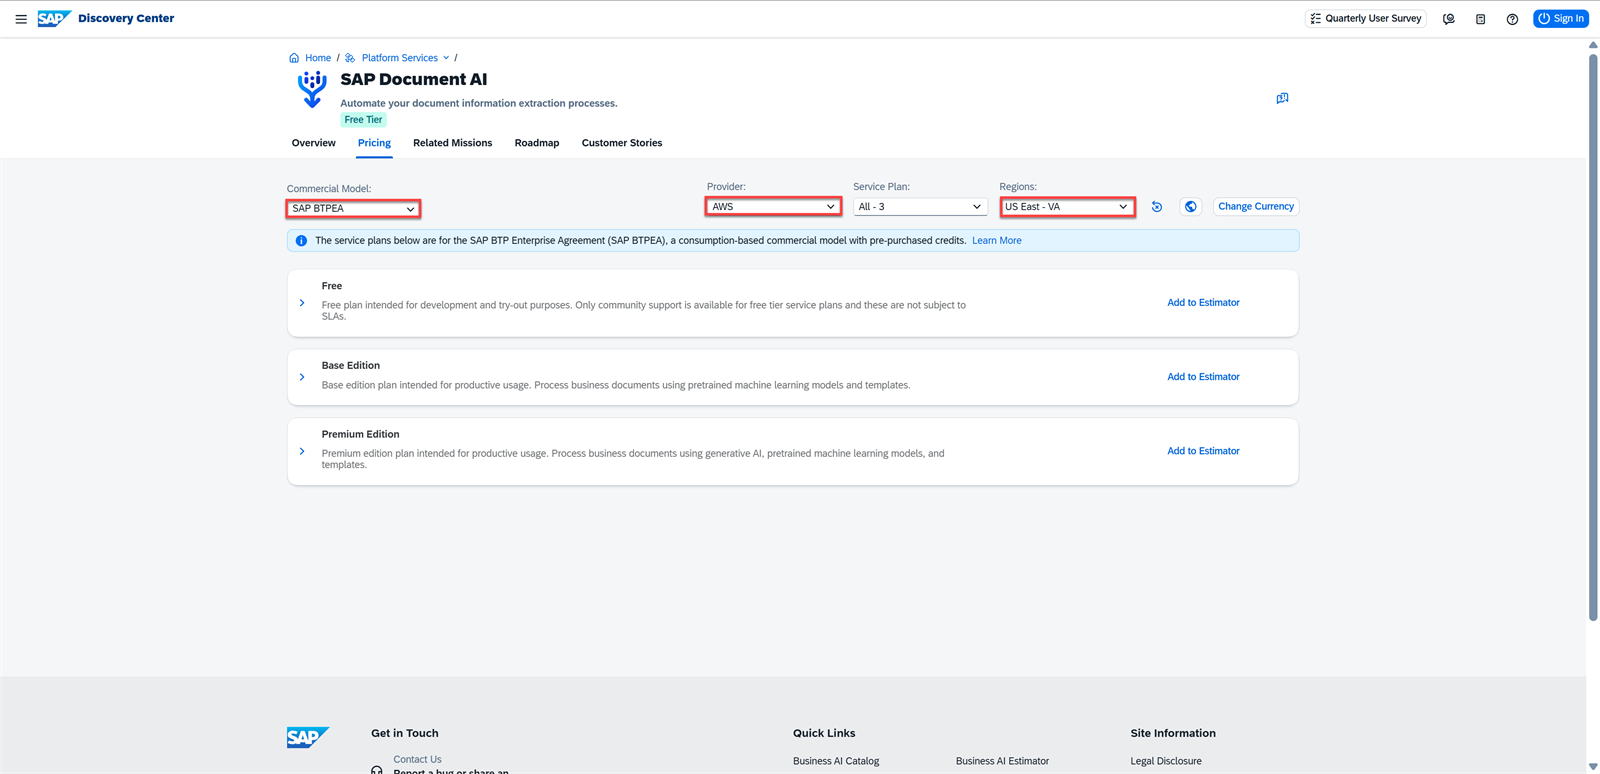
Entitlement. La global account tiene que tener cuota del servicio, y el plan correspondiente se asigna al subaccount, en una región donde el servicio esté disponible (más detalle en Entitlements y cuotas en SAP BAIP). En el SAP Discovery Center se puede comprobar qué planes existen según el modelo comercial, la región y el proveedor de infraestructura del cliente.
-
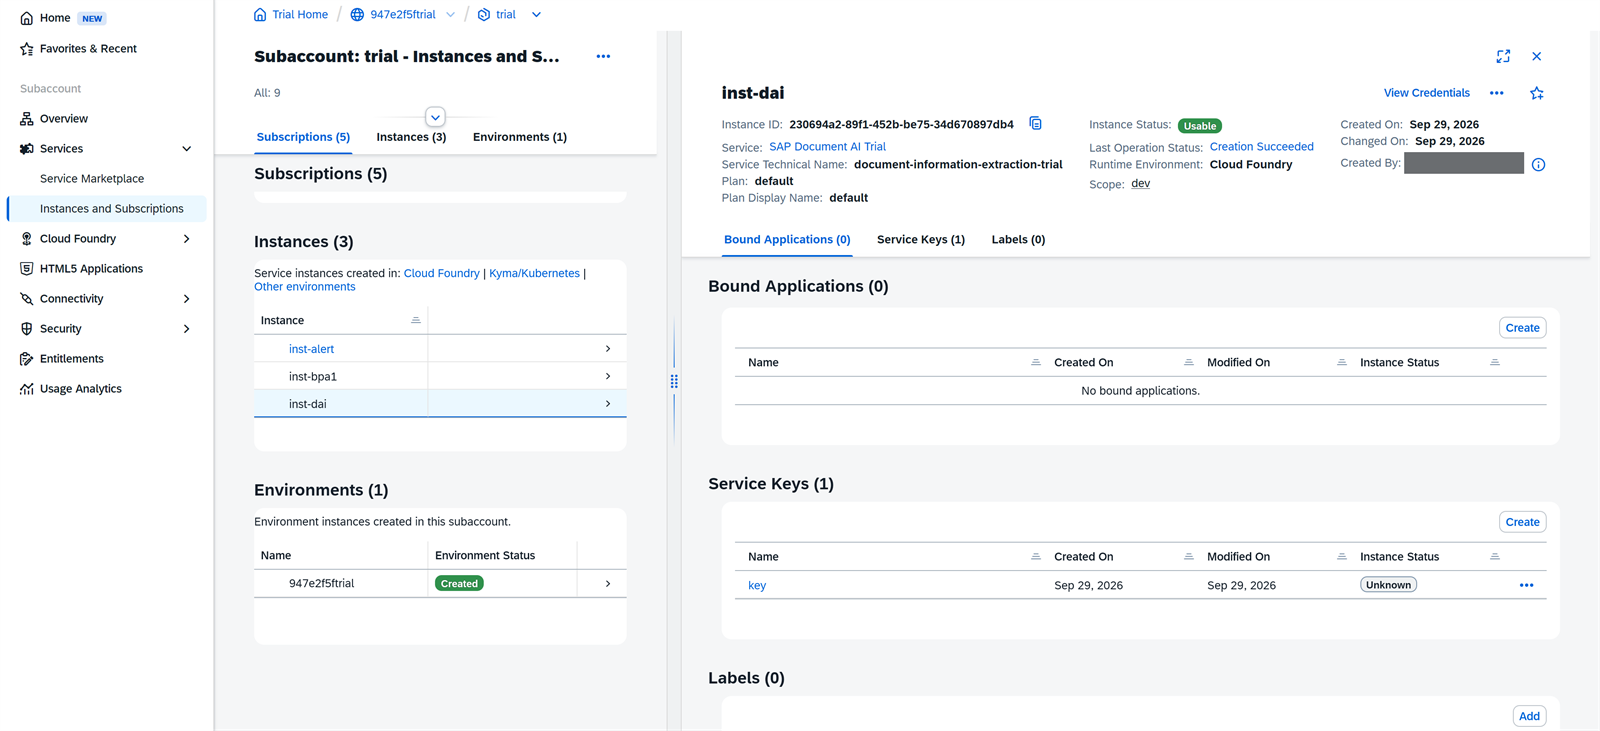
Instancia de servicio. En el subaccount se crea una instancia del servicio con el plan de la API.
-
Service key. Sobre la instancia se genera una service key. Contiene la URL de la API y las credenciales OAuth (client ID y client secret) con las que la capa de integración obtiene su token. Es lo que se configura en la destination, en el communication arrangement o en la aplicación que llame al servicio.
Para las personas:
-
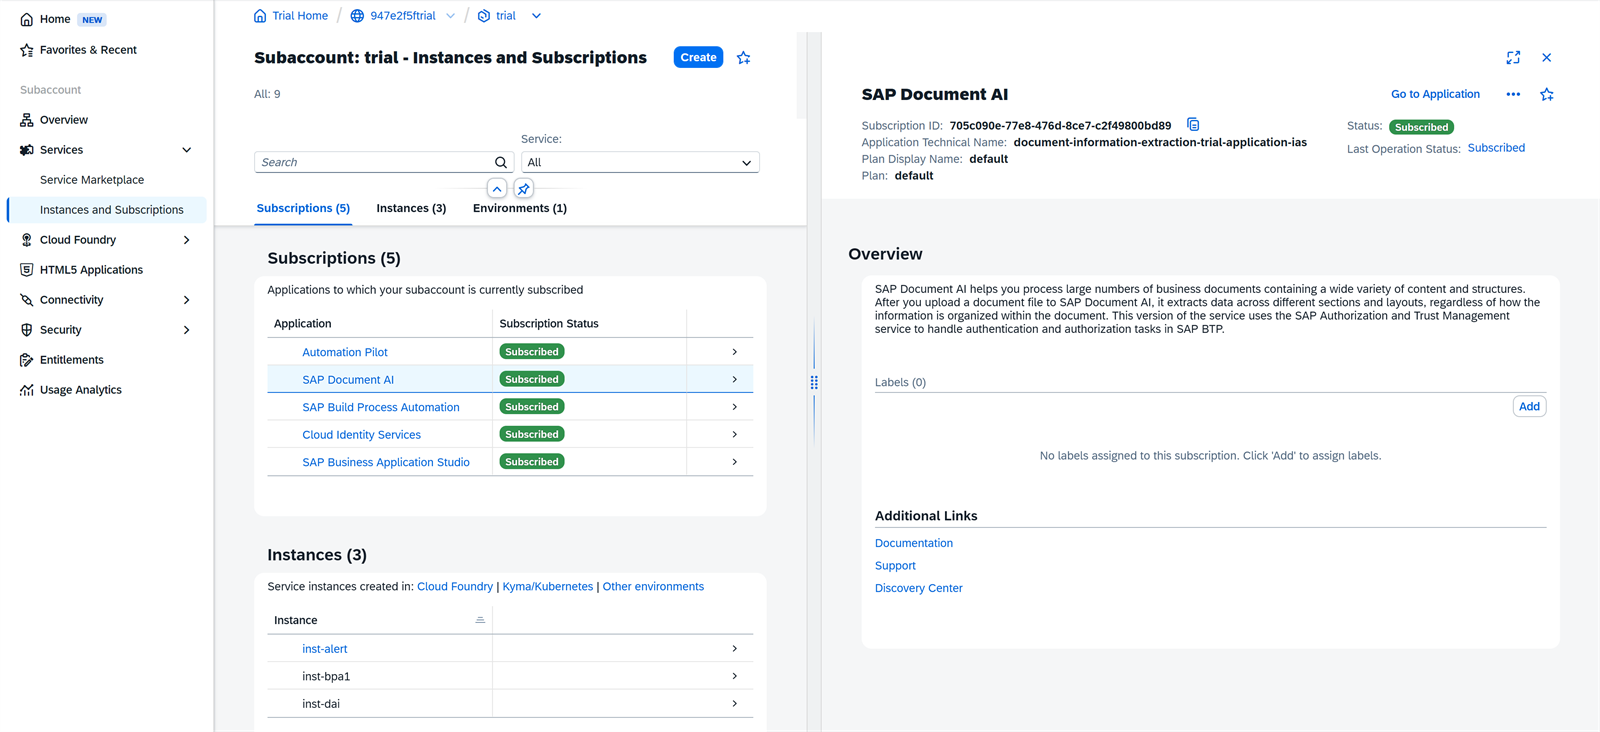
Suscripción a la UI. La interfaz web de Document AI se suscribe como aplicación en el mismo subaccount.
-
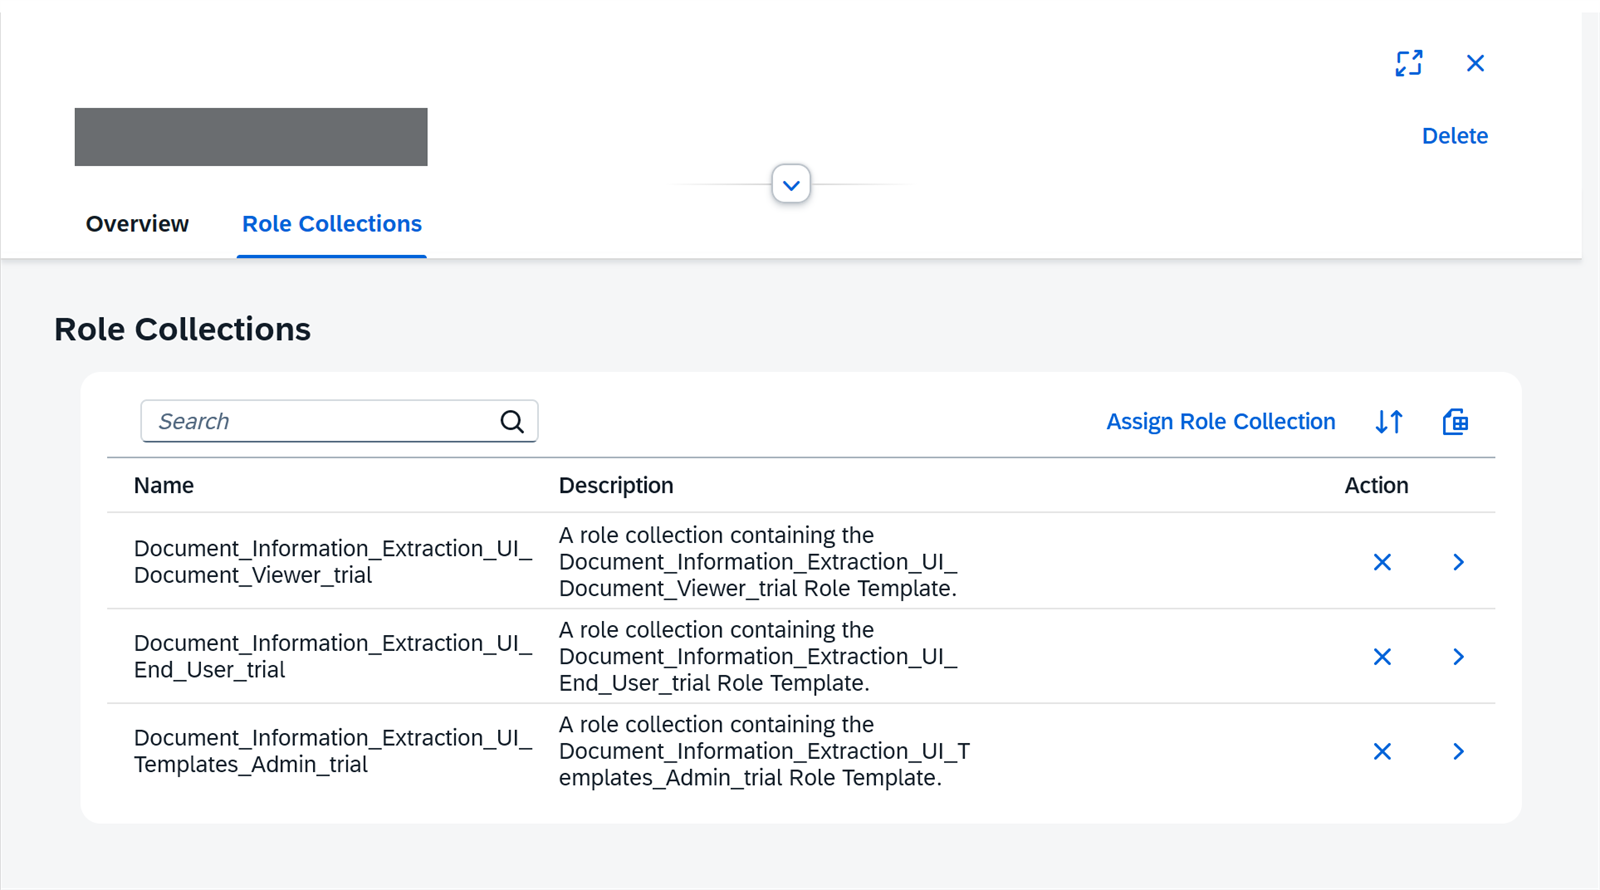
Role collections. Al suscribirse, el servicio crea tres role collections en el subaccount:
Document_Information_Extraction_UI_Templates_Admin: da acceso a todas las funciones de la interfaz, incluida la gestión de schemas y plantillas.Document_Information_Extraction_UI_End_User: para los usuarios finales que validan la ejecución y el resultado de la extracción de los documentos.Document_Information_Extraction_UI_Document_Viewer: solo permite visualizar los detalles del servicio, sin modificar nada.
En una cuenta trial los nombres llevan el sufijo
_trial, como se ve en la captura; en una cuenta empresarial no lo llevan. Conviene respetar esta separación: la persona que revisa no debería poder cambiar el schema del que depende la integración.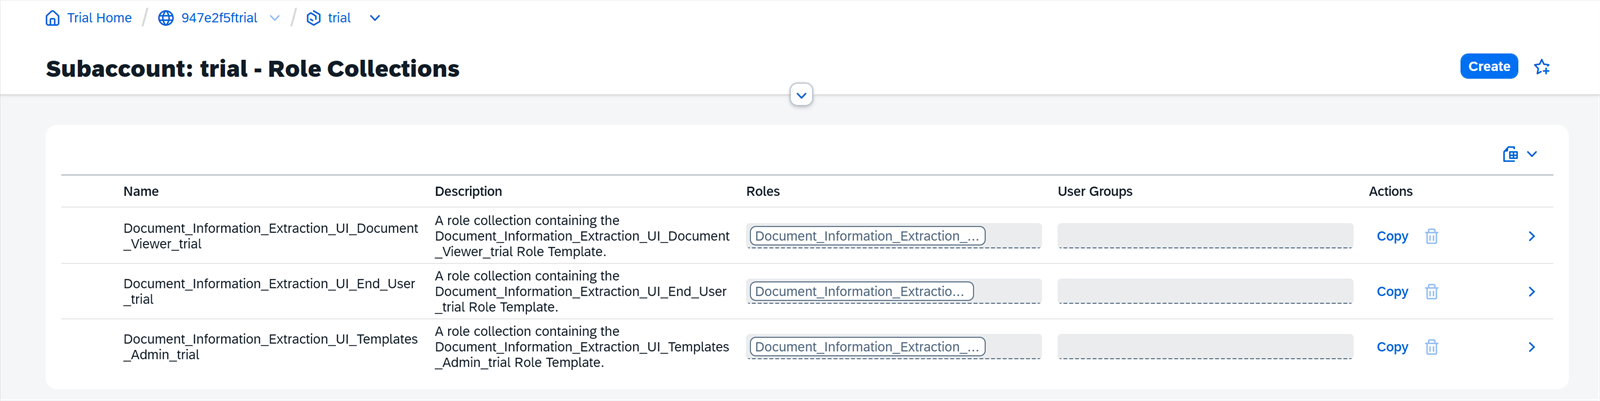
-
Usuarios. Las role collections se asignan a usuarios o grupos del Identity Provider configurado en el subaccount. El funcionamiento de role collections y usuarios en BAIP se detalla en Role collections, role templates y usuarios sombra en SAP BAIP.
¿Te ha resultado útil?
Gracias por tu valoración.
Comentarios
Aún no hay comentarios.